Digitaler Garten
Ich nehme meine Produktvideos nicht mehr neu auf. Ein Skript spricht jetzt 11 Sprachen.
Wie ich Produktvideos für AI Summary Helper aus einem Demo-Build rendere – Sprecher, Untertitel und Veröffentlichung in 11 Sprachen aus einer TypeScript-Datei.
Jedes Feature von AI Summary Helper braucht ein kurzes Video. Jede Sprache vervielfacht diese Arbeit. Aufnehmen, schneiden, untertiteln, vertonen, exportieren, veröffentlichen, mal elf. Bei der dritten Sprache wusste ich: Entweder höre ich auf, Features zu shippen, oder ich höre auf, Videos zu machen.
Also habe ich aufgehört aufzunehmen. Hier ist das Setup, bei dem ich gelandet bin, wie Claude da reinpasst, und die drei Dinge, die unterwegs kaputtgegangen sind.
Videos auf der Produktseite ansehen
1. Nimm nicht den Bildschirm auf. Steuere das echte Interface.
Die Extension hat einen Demo-Build: das echte Popup, eingebettet in eine Seite, mit einer gefakten Browser-API, die aufgezeichnete Inhalte abspielt. Kein Netzwerk, kein API-Key, nichts Zufälliges.
Die Videos werden aus dieser Demo mit einer virtuellen Uhr gerendert. Nichts streamt, bis der Renderer sagt „33 ms weiter“. Damit ist jeder Frame reproduzierbar, und ein Clip ist ein Skript: hier klicken bei 900 ms, das tippen bei 5,8 s, dort scrollen. Ein Wort ändern, neu rendern. Kein neuer Take.
2. Die Worte gehören in Code, nicht in eine Timeline.
Jeder Clip ist ein Eintrag in einer TypeScript-Datei: der Hook, der Sprechertext, die Untertitel und die Schritte, die der Cursor macht. Deutsch ist mein Referenztext. Jede andere Sprache wird aus der englischen Bedeutung geschrieben, im Register ihres Markts (förmliches „vous“ auf Französisch, schlichtes „你“ auf Chinesisch und so weiter).
Ein kleines Check-Skript sagt mir vor dem Rendern, was für eine Sprache fehlt oder falsch ist. Es gibt einen Haken aus oder eine Liste.
3. Ein Text, eine Stimme, eine Quelle der Wahrheit.
Die Sprachspur wird aus genau dem Text generiert, der auch der Untertitel ist, also können Ton und Untertitel nicht auseinanderlaufen. Das Audio liefert Wort-Timings, die Untertitel folgen ihnen, und ein Clip streckt sich selbst, wenn eine Sprache mehr Zeit braucht (Japanisch und Französisch heute).
Der Sprecher ist eine männliche Text-to-Speech-Stimme mit leichtem niederländischem Akzent. Das ist eine bewusste Markenentscheidung, und sie hat eine Macke: Wenn ein deutscher Hook mit einem Wort beginnt, das es auch im Niederländischen gibt, liest das Modell die ganze Zeile als Niederländisch. Deutsche Hooks müssen also mit unverkennbar deutschen Wörtern anfangen. Herausgefunden habe ich das durch Zuhören.
4. Veröffentlichen gehört zur Pipeline.
Ein Render ist nicht fertig, wenn die Datei existiert. Derselbe Durchlauf
- schneidet eine Web-Version zu, erzeugt ein Posterbild und exportiert Untertitel (WebVTT) aus den Wort-Timings,
- schreibt ein Manifest mit Dauer und Transkript, aus dem Video-Markup für Suchmaschinen und eine Video-Sitemap werden,
- sorgt dafür, dass jede übersetzte Seite ihre eigene Sprachversion des Videos bekommt,
- schreibt pro Clip und Sprache ein Briefing: Posttext, Hashtags, welche Communities passen.
Die Website selbst wird von einem CI-Job in 24 Sprachen übersetzt: Ändere einen englischen Satz, und ein paar Minuten später taucht ein Pull Request mit den Übersetzungen auf. Unveränderte Sätze behalten ihren Wortlaut, weil das vorherige Ergebnis gecacht ist.
Heute sind drei neue Clips in sechs Sprachen am selben Tag rausgegangen: gerendert, geprüft, exportiert und live.
5. Eine Person, ein paar Stunden pro Woche und Claude mit einem Rezeptbuch.
Ich bin Solo-Entwickler. Es gibt kein Videoteam, keine Lokalisierungsagentur und keinen Designer auf Abruf, nur eine kleine Zahl an Stunden und ein Produkt, das viele Sprachen sprechen muss. Das funktioniert nur, weil ich den Großteil der repetitiven Arbeit an Claude Code abgeben kann. Und damit das funktioniert, braucht es weniger clevere Prompts als das, was das Projekt dem Modell über sich selbst erzählt.
Das meine ich mit Rezepten:
- Skills für das Tool, das ich nicht auswendig kenne. Im Videoprojekt sind die Open-Source-Remotion-Skills installiert: zwölf Stück, zu Best Practices, Untertiteln, Rendering und der Doku. Bevor Claude eine Komposition anfasst, liest es nach, wie Remotion es gemacht haben will, also muss ich nicht in jeder Session eine Rendering-Library erklären.
- Ein Vertrag statt eines Prompts. Die README der Demo listet jeden URL-Parameter und jeden Automatisierungs-Hook auf: die virtuelle Uhr, die Szenarien, welcher Screen sich öffnen soll. Eine zweite README sagt, welche Dateien du für eine weitere Sprache brauchst. Ein neues Szenario oder eine neue Sprache heißt „folge der README“, für mich oder für Claude.
- Regeln, einmal aufgeschrieben. Neben dem Code liegt ein Content-Plan mit den Regeln für jeden Clip, etwa „keine Behauptung, die die Extension nicht halten kann“ und „jede Quelle in der Registry prüfen“. Jede neue Session startet mit denselben Regeln wie die letzte.
- Checks, an denen sich das Modell nicht vorbeireden kann. Das Sprach-Check-Skript, der ffmpeg-Frame-Test und die DOI-Abfragen entscheiden, ob etwas fertig ist. Nicht mein Eindruck vom Output und auch nicht der des Modells.
Die Extension, der Demo-Build und die Website sind Open Source in philffm/ai-summary-helper, und der Automatisierungsvertrag liegt in plugin/demo. Das Remotion-Projekt selbst ist ein separater Ordner neben diesem Repo und noch nicht veröffentlicht.
Wenn du allein ein Produkt in vielen Märkten betreibst, ist das der Tausch, den ich wieder machen würde: Investiere deine Zeit einmal in den Vertrag und die Checks, und lass die Maschine den Rest wiederholen.
Was kaputtging
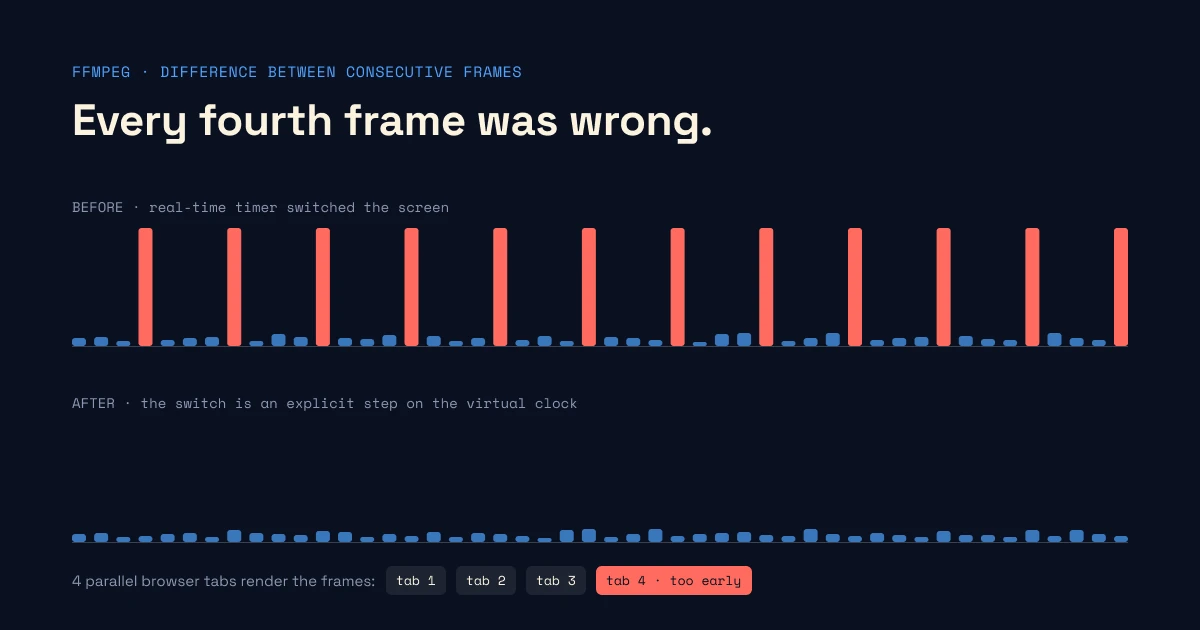
Jeder vierte Frame war falsch. Ein Clip flackerte, aber nur im finalen Render. Ich habe mit ffmpeg die Differenz zwischen aufeinanderfolgenden Frames gemessen und ein perfektes Muster gefunden: Jeder vierte Frame zeigte einen anderen Screen. Der Renderer nutzt vier parallele Browser-Tabs, und einer davon hat den Frame aufgenommen, bevor die Demo auf den richtigen Screen gewechselt war – weil dieser Schritt von einem Echtzeit-Timer gesteuert wurde und nicht von der virtuellen Uhr. Die Lösung: ein expliziter Schritt. Dieselbe Messung lasse ich jetzt bei jedem neuen Clip laufen, und sie dauert Sekunden.
Der Sprecher las Deutsch als Niederländisch. Siehe oben.
Ein KI-geschriebener Entwurf hatte falsche Quellen. Für Clips, die mit einem Forschungsfakt beginnen, enthielt ein früher Entwurf zwei DOIs, die auf die falschen Papers zeigten, und zwei Papers, die die Behauptung nicht stützten. Ich habe jede DOI in der Registry nachgeschlagen, die Behauptungen korrigiert, und behandle „ein Modell hat es geschrieben“ jetzt als Grund zu prüfen, nicht als Grund zu vertrauen.
Was ich jemandem sagen würde, der anfängt
- Mach das Produkt zuerst per Skript renderbar. Alles andere folgt daraus.
- Halte die Worte in einer Datei, mit einer Referenzsprache. Übersetzung ist dann eine Tabelle, kein Projekt.
- Messen statt schielen. Flackern, Lautheit, Untertitel-Timing, fehlende Strings: Wenn ein Skript es prüfen kann, sollte ein Skript es prüfen.
- Automatisierung ersetzt keine Muttersprachler. Sie bringt dich zu einem vollständigen, konsistenten Entwurf in jeder Sprache. Den letzten Schritt – jemand, der in dieser Sprache lebt und sagt „so sagt das niemand“ – habe ich nicht automatisiert.
Wenn du Japanisch, Chinesisch, Französisch oder Spanisch liest, kannst du mir sagen, wo meine Videos falsch klingen. Sie sind auf der Website, kostenlos anzusehen: https://ai-summary-helper.byphil.eu/blog/videos.html